Scheduled Health Checks on AWS Lambda
Projects |
AWS 리소스 상태를 주기적으로 점검하고 이상 감지 시 Slack/전화로 통보하는 서버리스 시스템입니다.
담당: 아키텍처 설계, Lambda 구현, 알림 연동 (온콜 정책과 대응 절차는 파트 협의)
1. Current Status
기존 구축, 일부 기능 운영 중
현재 전사 서버 모니터링은 Datadog(핵심 PG 영역) 과 Elastic Stack(그 외 서버) 이 담당합니다. 이 시스템은 그중 LB Target Group unhealthy 상태 점검에 주로 활용하고 있습니다.
아래 내용은 구축 당시의 설계와 구현을 기록한 것이며, 현재 운영 중인 기능과는 구분해서 읽어주세요.
2. Overview
AWS 리소스 상태를 EventBridge로 5분마다 주기 점검하고, 이상 상태가 지속되면 Slack 알림과 전화 발신으로 통보하는 서버리스 시스템을 설계/구축했습니다.
점검 주기가 5분이라는 뜻이며, 모든 장애를 5분 이내에 인지한다는 보장은 아닙니다. 상태 변화 시점, 지속 여부 판정, 통보 경로에 따라 실제 인지 시점은 달라집니다.
3. Background
What Triggered It
AWS 물리 호스트 장애로 운영 서버 1대가 응답 불가 상태에 빠진 일이 있었습니다. NLB 헬스체크 실패로 해당 인스턴스는 자동으로 트래픽에서 제외되어 서비스 영향은 없었지만, 새벽 시간대에 발생한 탓에 DevOps 파트가 인스턴스 장애 자체를 인지하기까지 수 시간이 걸렸습니다.
서비스는 이중화 덕분에 버텼지만, 인스턴스 장애를 빠르게 인지하지 못한 것이 문제로 지적되었습니다.
Root Causes
- EC2 상태 변화에 대한 자동 알람 체계 부재
- SSM 연결 끊김, Target Group Unhealthy 등에 대한 점검 없음
- 야간/주말 장애 시 담당자에게 통보할 온콜 체계 없음
이 사건의 개선책으로 주기적 상태 점검 시스템을 설계/구축하게 되었습니다.
4. Problem Statement
| 문제 | 영향 |
|---|---|
| 서버 상태를 수동으로 확인 | 장애 인지까지 수십 분~수 시간 소요 |
| 장애 알림 체계 부재 | 사용자 신고 후에야 인지 |
| 온콜 체계 없음 | 야간/주말 장애 대응 불가 |
5. Architecture
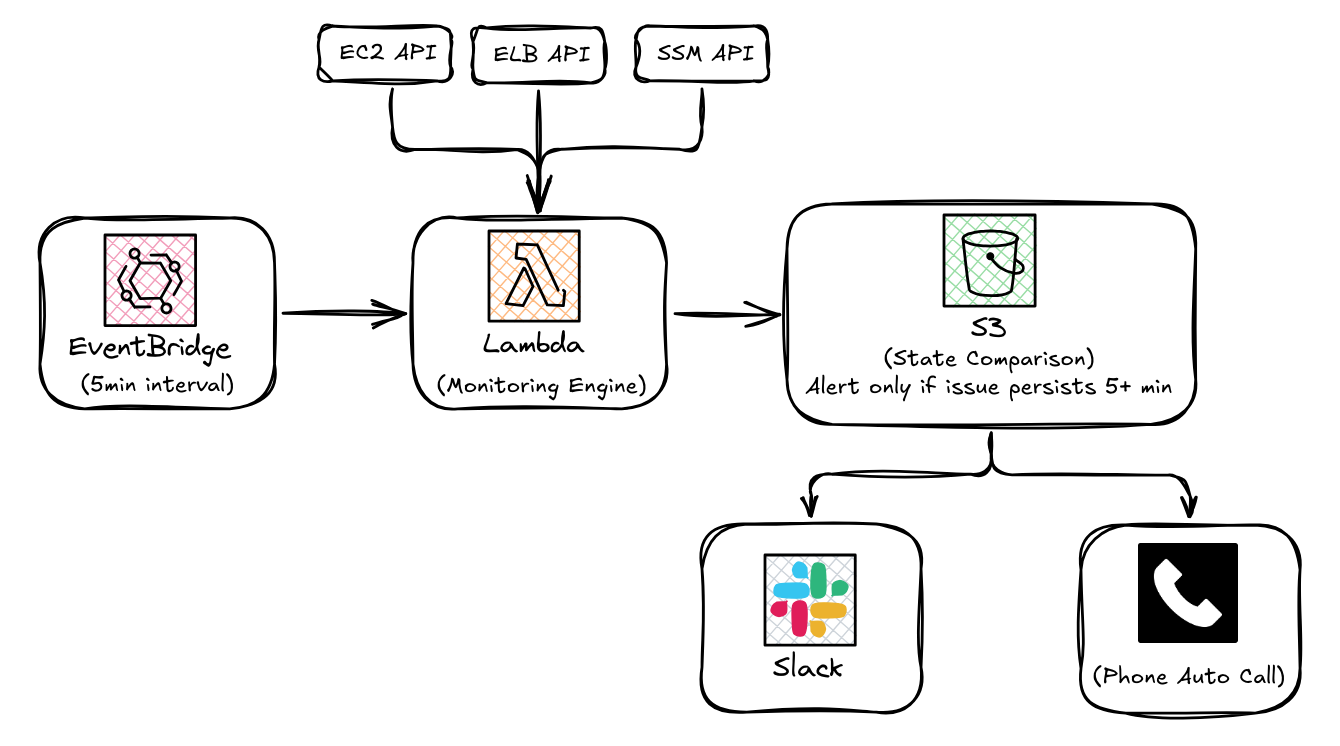
EC2 Monitoring Diagram
- Lambda + EventBridge: 5분 주기로 점검 함수 실행
- S3 상태 관리: 이전 상태와 비교하여 일정 시간 지속된 문제만 알림 (오알람 방지)
- 스누즈 기능: Slack 버튼 클릭으로 15분간 알람 차단 (알람 피로 방지)
- 심각도 분리: WARNING은 Slack만, CRITICAL은 Slack + 전화 발신
6. Monitored Checks
Core Checks
| # | 항목 | 방식 |
|---|---|---|
| 1 | EC2 Instance Status | EC2 API (running 여부) |
| 2 | SSM 연결 상태 | SSM API (online 여부) |
| 3 | Target Group Health | ELB API (healthy 여부) |
Additional Checks (Added in Operation)
| # | 항목 | 방식 |
|---|---|---|
| 4 | Disk 사용량 | SSM RunCommand (80%+ 알람) |
| 5 | Batch 실행 여부 | S3 마커 파일 확인 |
| 6 | 인증서 만료일 | 만료 D-30 사전 알람 |
7. Results at Launch
| 지표 | Before | After |
|---|---|---|
| 상태 확인 | 수동 확인 | 5분 주기 자동 점검 |
| 장애 인지 | 사용자 신고 또는 우연한 발견 | 이상 감지 시 Slack 통보 |
| 야간/주말 대응 | 불가 | 전화 발신 + 온콜 연계 |
8. Limitations & Current State
- 상태 점검은 UP/DOWN 판별까지이며, 리소스 추이나 로그 분석은 다루지 않습니다. 이 영역은 이후 ECK 기반 수집 플랫폼이 담당하게 되었습니다.
- Lambda 역시 함수 오류/타임아웃/호출 실패가 발생할 수 있으므로, 이 시스템 자체의 실패 가능성을 전제하고 운영해야 합니다.
- 현재는 전사 모니터링의 주력이 Datadog과 Elastic Stack으로 이동했고, 이 시스템은 LB Target Group 점검 용도로 남아 있습니다.
9. Used Skills
- AWS Lambda (Python)
- Amazon EventBridge
- Amazon S3 (상태 관리)
- SSM Parameter Store
- API Gateway (스누즈 엔드포인트)
- Slack Webhook + 전화 발신 연동